목소리가 공간이 되기까지
음성 인식부터 다면 LED 출력까지, 모든 단계를 자체 파이프라인으로 연결했습니다.
30초 동안 일어나는 일
스크롤하면 단계별 장면이 바뀝니다.
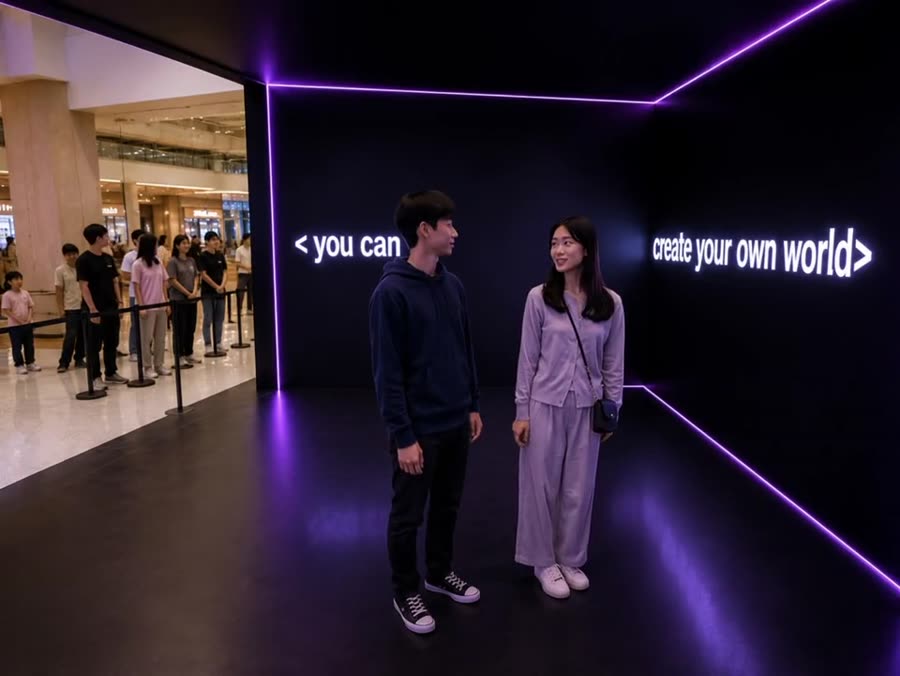
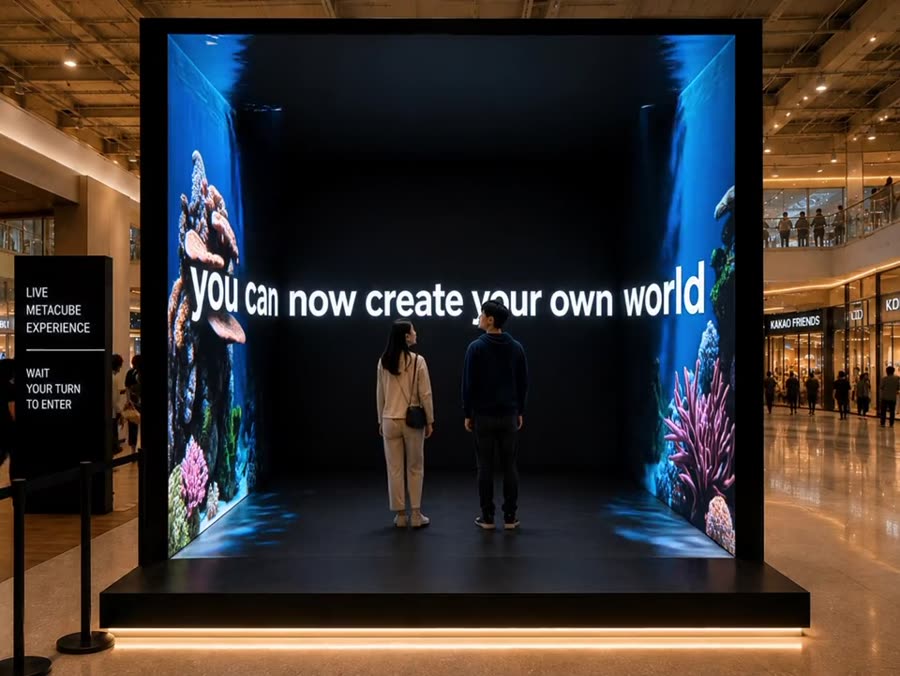
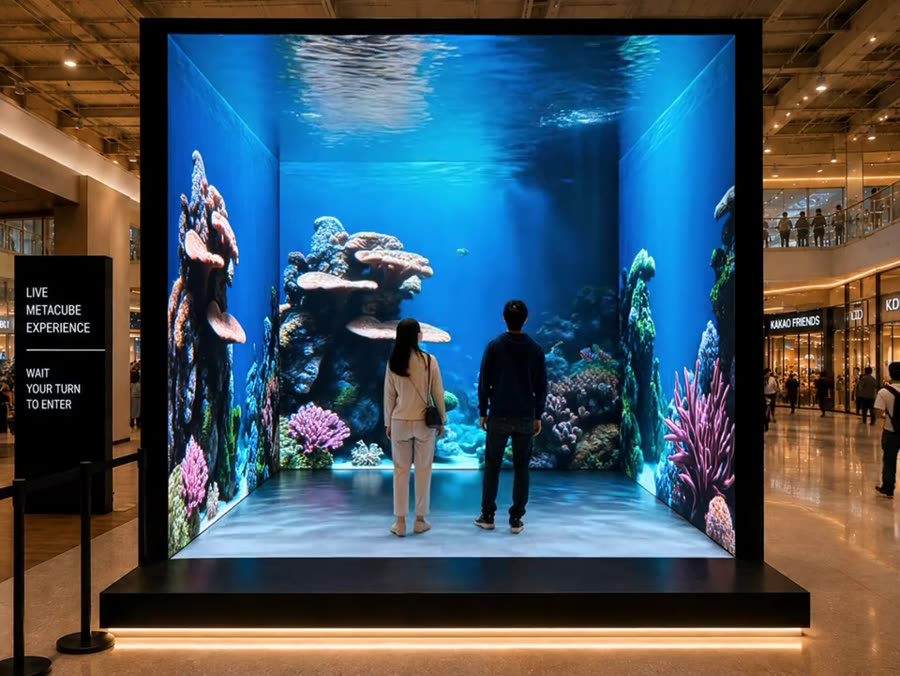
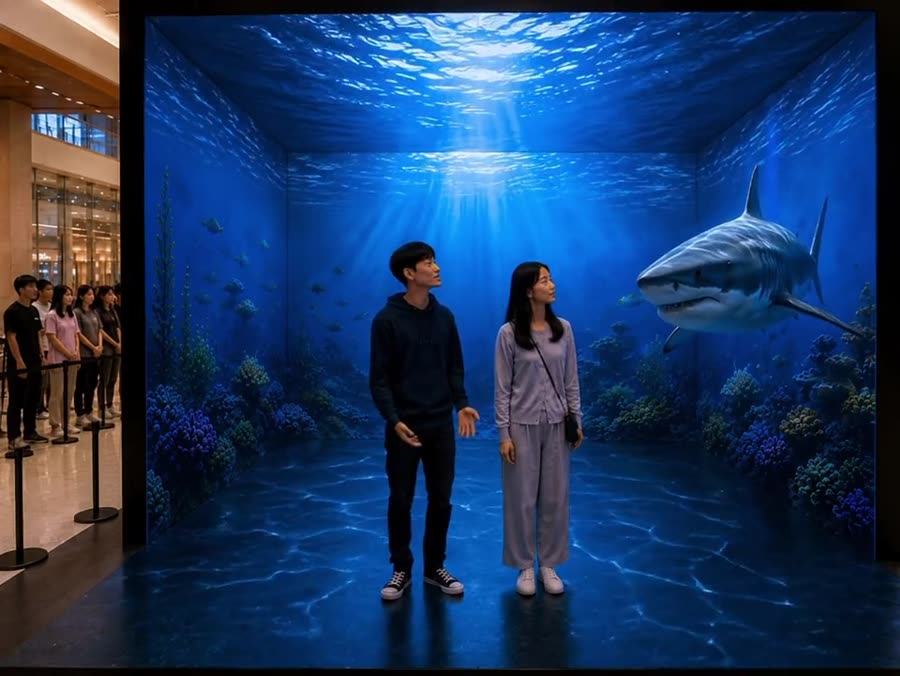
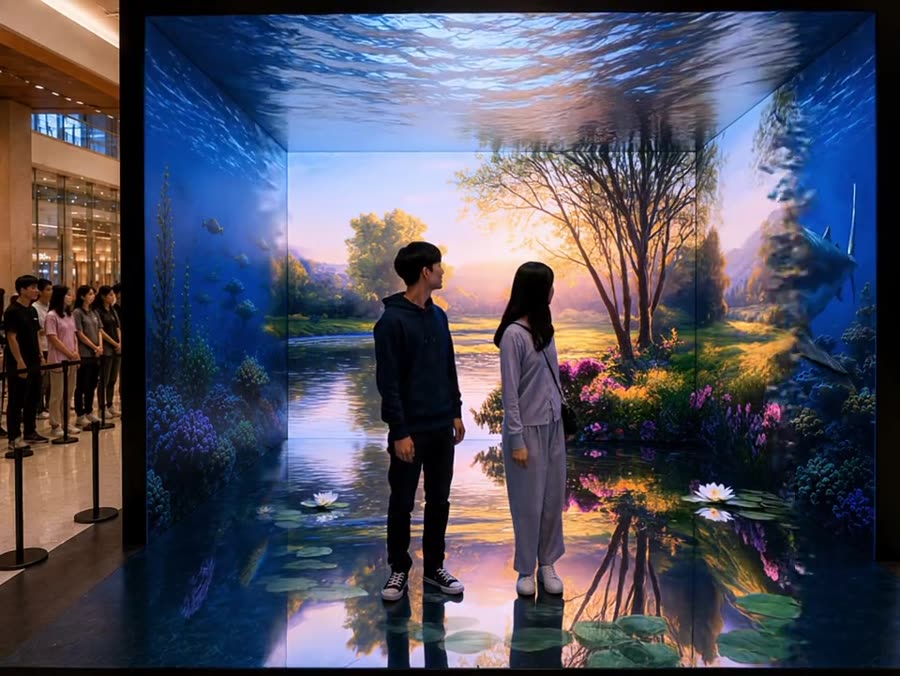
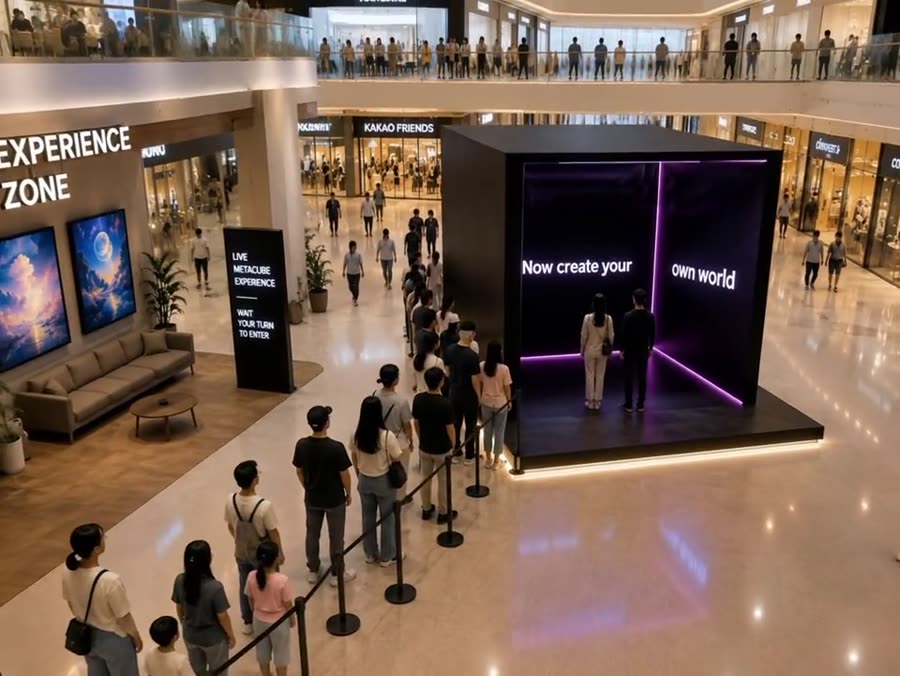 연출 이미지
듣기
음성 인식(STT, Speech-to-Text · 음성→문자 변환)으로 관람객의 말을 글로 옮깁니다.
이해
경량 언어모델이 요청을 장면 정보로 바꾸고, 안전 필터가 부적절한 요청을 걸러 냅니다.
그리기
생성형 AI가 공간 테마에 맞는 장면 이미지를 만듭니다.
움직이기
정지 이미지를 살아 움직이는 영상으로 바꿉니다.
가속
실시간 추론 최적화로 기다리는 시간을 줄입니다.
감싸기
여러 면의 LED에 이음새 없이 동시에 출력합니다.
핵심 기술
연출 이미지생성 파이프라인 오케스트레이션 서버
음성 인식, 언어모델, 이미지 · 영상 생성, 출력까지 각 AI 모듈을 하나의 흐름으로 묶어 관리합니다.
저작권 C-2026-047235
연출 이미지실시간 렌더링 클라이언트 엔진
생성된 장면을 여러 면의 LED에 이음새 없이 동시에 출력합니다.
저작권 C-2026-047234
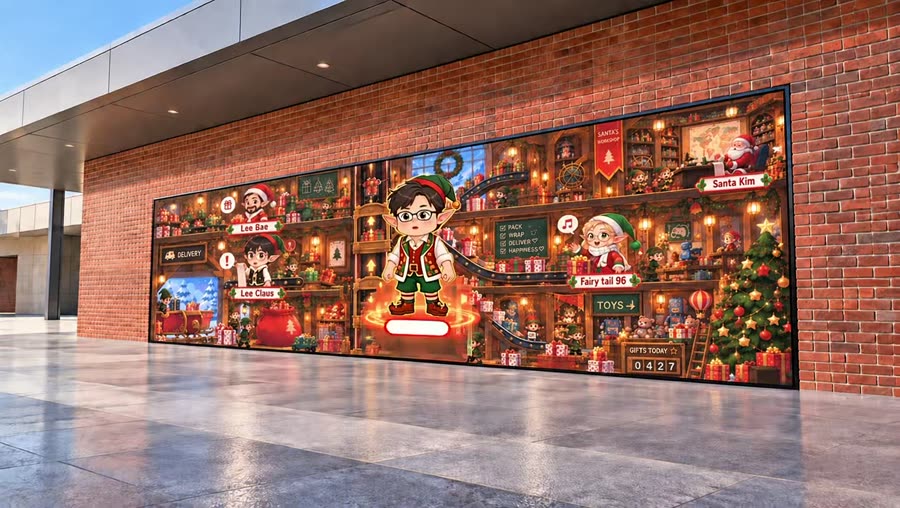 연출 이미지
캐릭터 자동 애니메이션
사진이나 3D 모델에 자동으로 뼈대를 만들고, 걷기 · 뛰기 같은 움직임을 실시간으로 생성합니다.
저작권 C-2026-047236 · 특허 출원 10-2026-0188398
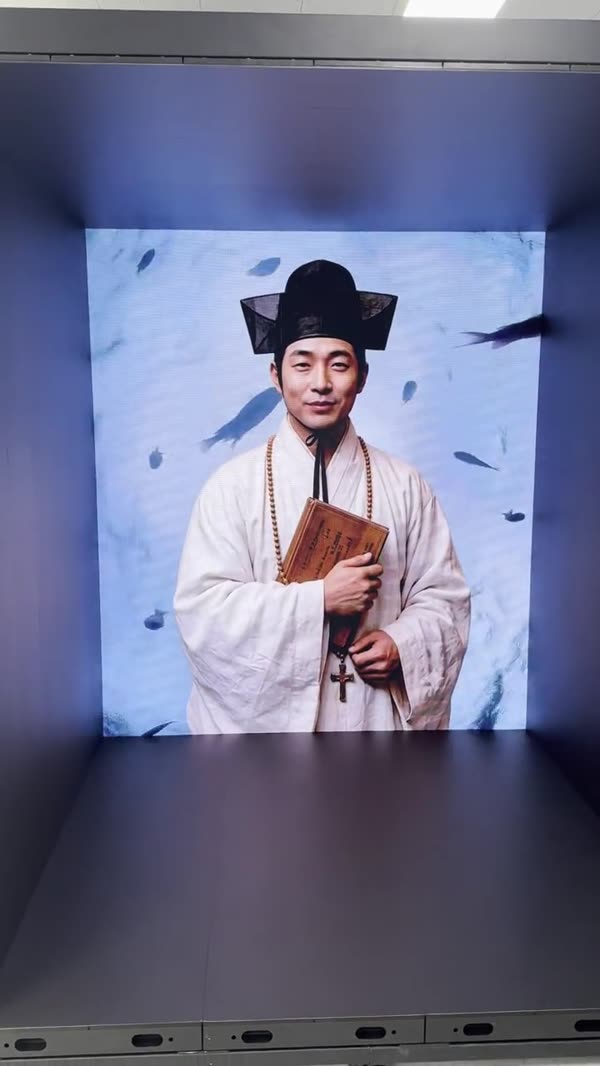 연출 이미지
인물 페르소나 엔진
인물의 기록을 학습해 근거 기반으로 답하고, 음성 · 표정과 동기화해 응답합니다.
인물 AI
말하기 전과 후
가운데 막대를 좌우로 움직여 비교해 보세요.
안전 · 운영
온프레미스 GPU 엣지 서버
외부 클라우드 없이 현장에서 생성합니다. 관람객의 음성과 사진은 현장 밖으로 나가지 않습니다.
콘텐츠 안전 필터
허용 표현 기반 필터와 생성 결과 검수로 공공장소 운영 기준을 지킵니다.
원격 무인 운영
원격 모니터링으로 현장 인력 없이도 상태를 확인하고 콘텐츠를 교체합니다.
R&D 로드맵
상용화
- 라이브 메타큐브
- 루미타운
- 인물 AI
고도화
- 동작 인식 다인원 인터랙션
- 시즌 테마 확장
- 생성 속도 단축
연구
- 3DGS 기반 실사 공간 재구성
- 다국어 음성 대화
3DGS: 3D Gaussian Splatting, 실사 사진으로 3차원 공간을 재구성하는 기술